| ★ |  Hyperparameter Tuning Tips that 99% of Data Scientists Overlook | | 5.7K | Estados Unidos | |
| 13 |  What is a Supercomputer for AI? How GPUs Drive Machine Learning | IBM Technology @ibmtechnology | 77.3K | Estados Unidos | 85 |
| 15 |  5 tips for OpenClaw | Greg Isenberg @gregisenberg | 65.6K | Estados Unidos | 84 |
| 17 |  Analyzing Deepseek's "undefined" NVIDIA PTX optimizations (with benchmarks!) | | 24.1K | Estados Unidos | 84 |
| 14 |  I built a GPT model in 10 hours | Looking Glass Universe @lookingglassuniverse | 18.1K | — | 84 |
| 10 |  Let’s Train YOLO26 Locally on NVIDIA DGX Spark | Nicolai Nielsen @nicolaiai | 7.4K | Dinamarca | 85 |
| 8 |  Lec 07. Scaling Rules for Optimization | MIT OpenCourseWare @mitocw | 5.9K | Estados Unidos | 85 |
| 7 |  Stanford CS25: Transformers United V6 I The Ultra-Scale Talk: Scaling Training to Thousands of GPUs | Stanford Online @stanfordonline | 4.6K | Estados Unidos | 85 |
| 11 |  Understanding Model Predictions with SHAP - XGBoost vs Neural Networks (375) | DigitalSreeni @digitalsreeni | 3.1K | Estados Unidos | 85 |
| 19 |  Keras 3 Distributed Training: Scaling Models with JAX using DataParallel, and ModelParallel | Google for Developers @googledevelopers | 3.1K | Estados Unidos | 84 |
| 2 |  Data Science Gamechanger? | | 2.5K | Estados Unidos | 86 |
| 1 | 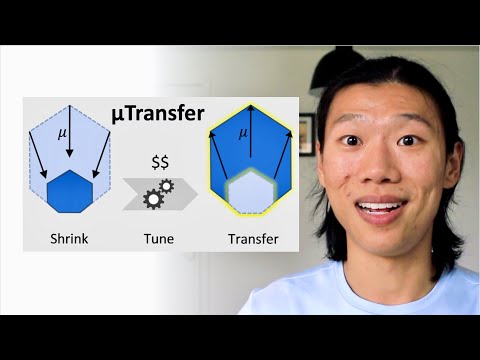 μTransfer: Tuning GPT-3 hyperparameters on one GPU | Explained by the inventor | | 1.6K | — | 88 |
| 5 |  LoRA - Explained! | CodeEmporium @codeemporium | 1.3K | Estados Unidos | 85 |
| 16 |  120 Billion Parameters: The Model Size Debate Explained! #shorts | Pew Moments @pewmoments90210 | 1.1K | — | 84 |
| 3 |  Performance Optimization and Software/Hardware Co-design across PyTorch, CUDA, and NVIDIA GPUs | | 669 | Reino Unido | 86 |
| 4 |  NVIDIA DGX Spark™ Review: Better Than Renting an H100? (2026) | Savage Reviews @savagereviewsofficial | 563 | Estados Unidos | 86 |
| 18 |  LLM (Parameter Efficient) Fine Tuning - Explained! | CodeEmporium @codeemporium | 558 | Estados Unidos | 84 |
| 20 |  Fixing GPU Starvation in Large-Scale Distributed Training | | 321 | Reino Unido | 84 |
| 6 |  Track robotics training dynamics in Weights & Biases | Weights & Biases @weightsbiases | 284 | Estados Unidos | 85 |
| 9 |  Boost Your GPU Performance with These HIDDEN Tips! #shorts #windows10 | Tech Bytes @techbytes-13-v4b | 194 | India | 85 |
| 12 |  Optimize GPU Geometry with meshoptimizer: Complete Pipeline Explained | | 57 | Estados Unidos | 85 |