| ★ |  Let's Build Pipeline Parallelism from Scratch – Tutorial | freeCodeCamp.org @freecodecamp | — | Estados Unidos | |
| 17 |  CUDA Programming for NVIDIA H100s – Comprehensive Course | freeCodeCamp.org @freecodecamp | 105.5K | Estados Unidos | 87 |
| 3 |  Deploying AI Models with Hugging Face – Hands-On Course | freeCodeCamp.org @freecodecamp | 75.0K | Estados Unidos | 89 |
| 15 |  Lessons From Training Composer At Cursor And Building Meta/Nvidia Compute Clusters | YC Paper Club | | 68.6K | Estados Unidos | 88 |
| 20 |  LangGraph Complete Course For Beginners (From ZERO To HERO) | | 31.3K | Canadá | 87 |
| 16 |  Generative AI Full Course For Beginners (Data Domain Edition) | | 29.3K | Canadá | 88 |
| 19 |  AI Just Built Its Own Deep Learning Engine… And It Actually Works | AI Revolution @airevolutionx | 28.1K | Estados Unidos | 87 |
| 9 |  RAG Tutorial For Data Engineers (From ZERO To PRO) | | 21.7K | Canadá | 88 |
| 13 |  Data Pipelines in 8 minutes: Streaming, Batch, and on-demand | | 14.6K | Estados Unidos | 88 |
| 6 |  TensorFlow Tutorial: From Tensors to Training | | 13.8K | Estados Unidos | 88 |
| 10 |  Building AI Agents in Pure Python - Beginner Course | Dave Ebbelaar @daveebbelaar | 9.8K | Países Bajos | 88 |
| 1 |  Stanford CS25: Transformers United V6 I The Ultra-Scale Talk: Scaling Training to Thousands of GPUs | Stanford Online @stanfordonline | 4.6K | Estados Unidos | 89 |
| 14 |  Keras 3 Distributed Training: Scaling Models with JAX using DataParallel, and ModelParallel | Google for Developers @googledevelopers | 3.1K | Estados Unidos | 88 |
| 11 |  I used AI to build a data pipeline in 30 minutes!! | Avery Smith | Data Analyst @averysmith | 1.7K | Estados Unidos | 88 |
| 5 | 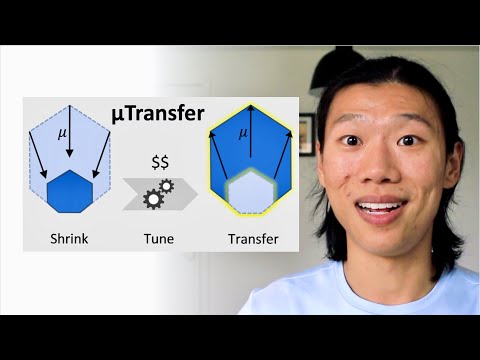 μTransfer: Tuning GPT-3 hyperparameters on one GPU | Explained by the inventor | | 1.6K | — | 88 |
| 18 |  Neural Collaborative Filtering Code Walkthrough - Recommender System | DigitalSreeni @digitalsreeni | 786 | Estados Unidos | 87 |
| 8 |  Performance Optimization and Software/Hardware Co-design across PyTorch, CUDA, and NVIDIA GPUs | | 669 | Reino Unido | 88 |
| 2 |  Fixing GPU Starvation in Large-Scale Distributed Training | | 321 | Reino Unido | 89 |
| 7 |  Accelerate LLM post training with W&B Serverless SFT | Weights & Biases @weightsbiases | 282 | Estados Unidos | 88 |
| 12 |  Uv Python Toolchain: From 100x Faster Packaging to OpenAI's Agent Runtime | | 168 | Estados Unidos | 88 |
| 4 |  Building an LLM: A Complete Guide to Creating Your Own Large Language Model from Scratch | One Minute Finance @oneminutefinance | 137 | Reino Unido | 89 |